1人QAで2週間ごとのリリースを回す ── AI、Maestro、手動テストの役割分担
こんにちは。AnotherBallでAvvyのQAエンジニアをしているKyleです。実は、AvvyのQAエンジニアは私1人しかいません。
QAは立ち上げ当初からこの人数で、大規模な機能追加があるときだけ、パートタイムのQAメンバーにも加わってもらいます。AIの導入によって開発スピードが上がり、さらに開発チームも大きくなってきました。その分、リリースごとにQAが対応すべき作業量も増えています。それでも少人数のQA体制のまま開発のペースについていけていて、QAがボトルネックになってリリースが遅れることもありません。
Avvyは2Dアバターの姿で配信できるライブ配信アプリです。リリースは2週間ごとで、大きな機能が入るときはもう少し間隔が空きます。1回のリリースでの変更は、サーバー、Unityのアバター部分、iOSとAndroidのアプリにまたがります。あるレイヤーで起きたバグが、別のレイヤーで表に出る場合もあります。この構成については、モバイルチームが以前の記事で紹介しています。
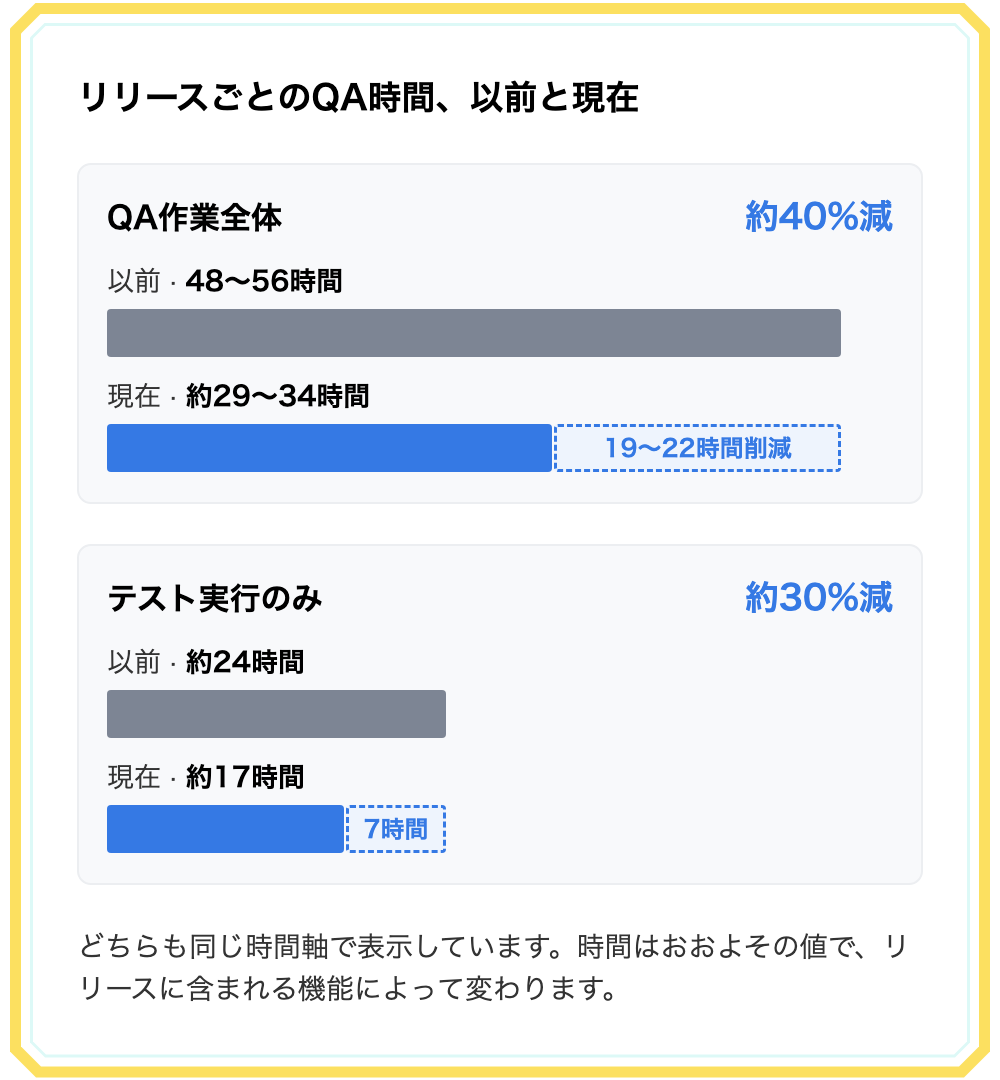
1リリースあたりのQA作業には、以前は48〜56時間ほどかかっていました。チケットの理解から、テスト戦略の立案、テストケース設計、テストの実行、バグ修正の再テスト、アプリ申請のGOサインまでを含めた時間です。AIによるテストケース設計をはじめ、AIと自動化のツールを取り入れたことで、この時間は約40%減りました。一方で、AIが作った成果物のレビューやツールの改善にも時間がかかるため、現時点の削減はこのくらいにとどまっています。ツールが良くなって結果の信頼性が上がればレビューの手間が減るので、この数字はさらに伸びると考えています。
テストの実行だけを見ると、以前は約24時間かかっていたものが約30%減りました。大きく減ったのは、テストを実行する前の工程です。AIはチケット上の議論、コメント、仕様の更新、Figmaをまとめ、食い違いがあれば質問を出し、関連するチケットも示してくれます。コードの差分からリグレッションの範囲も割り出します。アプリだけでなく、コードそのものを見られるからです。チケットの整理もリグレッション範囲の割り出しも、資料やコードを読み解く作業が中心です。AIが一番時間を減らしてくれたのは、この部分でした。
初めてAIにアプリをテストさせたとき
初めてAIによるアプリのテストを見たとき、驚いたのは自動化スクリプトを一切使っていなかったことです。AIが自律的にアプリを起動し、設計したテストケースに沿ってテストを進めていきます。しかも当時の設計は、それほど詳しく書かれたものではありませんでした。同時に、設計をもっと具体的に書き、スキルを改善していけば、信頼できるテストの手段になり得ると気づきました。毎回同じ結果になる自動テストや、手動のQAを置き換えられる段階にはまだありません。それでも、QAエンジニア1人で毎回のリリースに追いつくための大きな支えになっています。
ここでいうスキルは、Claude Codeのスキルのことです。指示を書いたMarkdownファイルと、いくつかの補助スクリプトでできています。私のQA作業のうちAIが担う部分は、それぞれが1つのスキルです。指示の多くは、実行時の失敗を受けて私が書き足してきたルールです。どのスキルも、まだ完成形ではありません。AIの結果は私がレビューし、各スキルの信頼性も確かめ続けています。
作業の分担
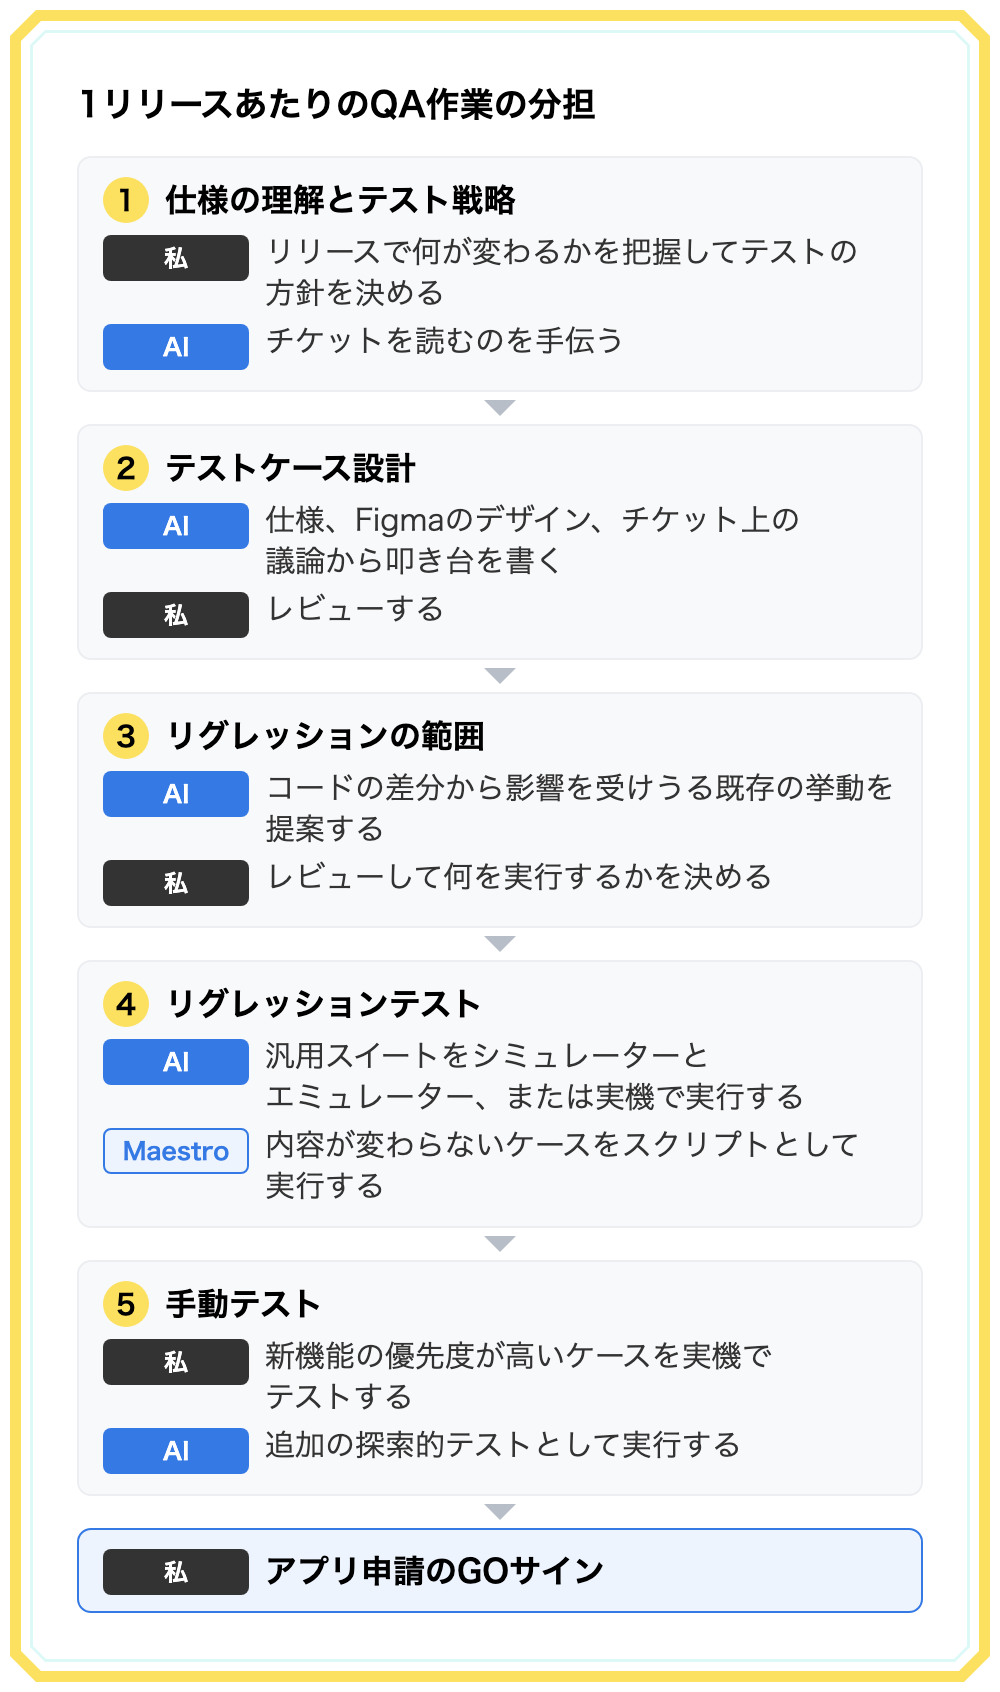
作業は次の5つに分かれます。
仕様、Figma、議論からテストケースを設計する
最初のスキルは、Linearのチケットを受け取ってテストケース設計の叩き台を作ります。使う前には必ず私がレビューします。チケットの説明文だけでは足りません。決定はコメント欄やサブチケット、親のエピックで覆ることがあり、受け入れ条件を書いたAcceptance Criteriaの欄は最初に書かれたまま残っていることが多いからです。そこでスキルは、関連するチケットをまとめて読みます。コメントと仕様が食い違っていたら新しいほうに従い、その食い違いをチームへの質問として記録します。古くなったチケットを黙って見過ごさず、直してもらうためです。
実例を紹介します。Avvyのフリマでは、ユーザー同士がアバターアイテムをコインで売買できます。このフリマで、出品者が出品中の価格を編集できるようになりました。エピックの要件には「出品者が編集している間は購入が成立しない」とあり、出品がロックされるように読めます。ところがサブチケットのコメント欄で、開発者たちは別の決定をしていました。購入は成立し、出品者の保存はサーバーのエラーメッセージとともに拒否され、編集画面は開いたままになる、というものです。
スキルはこの決定を見つけてテストケースをそれに合わせて書き、要件が古くなっていることを指摘しました。さらにコードも確認し、ロックの仕組みはどこにもないことを突き止めています。唯一の安全策は、新しい価格を保存すると、購入者が旧価格ですでに開いていた購入手続きが取り消されることだけでした。要件が示している保証とは別物なので、これはチームへの質問として上げました。手作業でこれをやるには関連チケットのスレッドを全て読む必要があり、以前はそこに多くの時間を取られていました。
他にも効いているルールが2つあります。1つ目は、要件を作らないことです。仕様に書かれていない挙動については、Expected Resultを推測で埋めず、プロダクト、デザイン、エンジニアリングのいずれかに向けた質問を書きます。2つ目は、Figmaを数値で読むことです。「レイアウトがFigmaと一致していることを確認する」というケースは、実際の確認作業をテストする人に丸投げしているだけです。そこでスキルはFigma MCPサーバーを通じてフレームの座標とデザイントークンを取得し、アプリのコードと比べて、人が画面で確かめられる期待結果を書きます。Figma MCPサーバーは、AIがFigmaのファイルを直接読めるようにするコネクタです。実際の出力は英語で、次のようになります。
1 | The button is inset 8dp from the thumbnail's top-right corner, |
デザインとコードが食い違っていたら、デザインを正とします。各ケースにはHigh、Medium、Lowの優先度も付き、後で私が手動でテストする範囲はこの優先度で決まります。
コードの差分からリグレッション範囲を洗い出す
チケットに書かれているのは何を変えるつもりかであって、その変更が他のどこに触れたかではありません。そこでスキルはケースを書く前に実装の差分を読み、最後に「Regression — diff-derived」というセクションを追加します。チケット上では変更対象として想定されていなかった画面、差分が触れた共通コンポーネントを使う他の画面、削除されたのにまだ参照されているかもしれない文字列や画像などが対象です。このセクションはリグレッション範囲についてのAIからの提案で、実際に何を実行するかは私がレビューして決めます。
ここで私が一番大事にしているのは、コードはテスト観点を見つけるための情報源であって、期待結果を決める基準ではない、というルールです。期待結果を今のコードの挙動に合わせてしまうと、そのケースは失敗しようがなく、実装の誤りを検出できません。コードと仕様が食い違っていたらケースは仕様に合わせて書き、その差はチームへの質問にします。
リグレッションテスト①:AIが汎用スイートを実行する
どのリリースでも、同じ汎用リグレッションスイートを実行します。今はE2Eテストケースが53件あります。リグレッションスキルは両アプリの最新のリリースブランチをビルドし、全ケースをiOSシミュレーターとAndroidエミュレーターで実行して、結果をSlackに投稿します。全ケースは、iPhoneやPixelの実機でも直接実行できます。スクリプトは使わず、シミュレーターのときと同じように、AIが1ステップずつ端末を操作します。夜間に実行を始めてマシンを稼働させたままにし、翌日に結果をレビューすることもあります。先ほど書いた最初の実行もこのスキルによるもので、それ以来、3つの教訓を経て信頼性が上がってきました。
必ず最新のコミットからビルドする
ある回の実行では、手元のリリースブランチが2コミット遅れていました。Gradleは全て最新だと報告し、アプリも普通に起動しましたが、抜けていたコミットはUnity as a Library、略してUaaLのバージョンアップでした。UaaLは両アプリに組み込んでいるUnityのビルドで、スイート内のアバター画面は全てこれに依存しています。レポートは正しく見えるのに、違うビルドをテストしていたことになります。今はどの実行も、ローカルのコミットがリモートのブランチと一致することを確認してから、新しくビルドしてインストールします。実機の場合は、インストールされているビルドが最新のリリースビルドであることを確かめます。これを通るまで、ケースは1つも実行しません。
ケースごとに実際の結果に即したステータスを付ける
放っておくと、AIはタップでエラーが出なかったというだけで合格と報告しかねません。そこで期待結果を画面上で実際に確認できたときだけPASSEDとし、ステータスも2つではなく6つ用意しています。
| ステータス | 意味 |
|---|---|
| PASSED | 期待結果を確認できた |
| FAILED | 実際の挙動が期待結果と食い違った |
| BLOCKED | シミュレーターでは実行できない、または前の失敗のせいで辿り着けない |
| MANUAL | スイート上で手動専用とされている。AIは実行しない |
| NOT RUN | 実行したが、どちらとも確認できなかった |
| N/A | このプラットフォームには該当しない |
一番効いているのはNOT RUNです。確認できなかったことをそのまま報告できるので、AIが無理にPASSEDかFAILEDのどちらかに振り分けずに済みます。MANUALをBLOCKEDと分けているのは、私が手動でテストすると決めたケースのせいで、問題のない実行が壊れているように見えないようにするためです。
FAILEDが必ずしもバグとは限らない
古くなっているのがスイートの記述のほう、ということもあります。スイートのテストケースには、名前の入力が文字数の上限に達すると、それ以上入力できなくなると書かれていました。実際のアプリでは入力は続けられますが、「Exceeds character limit」と表示されて保存ボタンが押せなくなります。文字数の制限そのものは機能していて、変わったのは制限の仕組みだけです。このケースも、記述とのずれを隠さないようFAILEDとして記録します。ただしレポートではアプリの不具合とは分けてまとめ、テストケースの新しい記述も提案します。そうしないと、開発者が存在しないバグを探し回ることになります。
リグレッションテスト②:変わらないケースをMaestroのフローにする
AIによる実行は柔軟です。自然言語で書かれたケースを読み、どう実行するかを自分で考えてくれます。その分時間がかかり、結果のレビューも必要です。内容が変わらないケースなら、毎回同じように動くスクリプトのほうが向いています。MaestroのフローはAndroidの実機でそのまま実行できます。ただ、Maestro本体のCLIはiPhoneの実機に対応していません。そこでiOSでは、Maestroのフローを実行できるオープンソースのツールmaestro-runnerを使い、iPhoneの実機でも同じフローを動かしています。
そこで、リグレッションケースをMaestroのフローに変換し始めました。最初の対象はユーザーのブロックとブロック解除です。スキルがフローを書き、両アプリ共通のUIタグ、つまり安定したテストIDを追加して、開発者がレビューするPRを作ります。私の承認がない限り、何もコミットしません。パイロットで得た教訓は2つです。
- フローの終了時には、アカウントの状態を元に戻すこと。 ブロックしたら、同じ実行の中で解除する。そうしないと、次の実行がアプリとは関係のない理由で失敗する。
- 「Select all」と「Select All」のような小さなプラットフォーム差で、テキストによる要素の指定は壊れる。フローが表示テキストではなくUIタグを使っているのはこのため。
ここはまだ始まったばかりです。Maestroがカバーしているのは今のところリグレッションケースだけで、新機能向けのフローは準備中です。フローを生成するスキルの信頼性も、まだ評価している段階です。
今も手動でテストしているところ
手動テストがなくなったわけではありません。重点を置く範囲が変わっただけです。
今の私の時間は、新機能の優先度Highのケースを実機でテストすることに使っています。誤ってPASSと判定したときの影響が特に大きい領域だからです。課金、カメラとフェイストラッキング、実機GPUでのUnityの描画、2つ目のアカウントを使う配信、プッシュ通知など、シミュレーターではできないことは全てここに入ります。Avvyでは、特定のPixel端末でしか再現しないアバターのバグもありました。サインインとアカウント作成も私が行います。AIは、テスト用アカウントであっても認証情報を入力しないからです。
AIや自動化では、まだ確認できないものもあります。アバターの見た目が正しいか、配信の音がちゃんと聞こえるかは、今も人が目と耳で確かめています。いずれはどちらもAIと自動化でカバーできるよう、R&Dを進める予定です。また、本番環境のテストにはまだAIを使っていません。本番環境でのテストは、手動か自動化だけで行っています。
AIを追加の探索的テストに使う
新機能のテストでもAIを使っていて、こちらは探索的テストとして扱っています。機能テスト用のスキルはチケットのリリースをビルドし、設計したテストケースを実行します。各ケースには、PASS、FAIL、NEEDS MANUALのいずれかの結果と、その理由が付きます。リグレッションスキルの6つのステータスとは別の、機能テスト用の分け方です。AIがバグを報告したら、まず私が手動で再現します。再現すれば起票し、再現しなければ誤検知として扱って、そのケースをスキルの改善に回します。優先度Highのケースが通っても、それは良い兆候であって、OKのサインではありません。
あるリリースで見つかった2つのバグが、この追加のテストが得意なことをよく表しています。どちらもAndroidで、仕様には書かれていないケースから見つかりました。
1つ目はフリマ画面です。出品が20件以上ある状態でネットワークを切って引っ張って更新し、ネットワークエラーを閉じてからネットワークを戻し、下にスクロールして続きを読み込みます。すると次のページではなく1ページ目がもう一度読み込まれ、下に重複して表示されました。原因は、更新のたびに、リクエストを送る前にページングのカーソルを消していたことです。オフラインで更新が失敗した時点でカーソルはもう残っておらず、次の読み込みでサーバーに1ページ目を要求していました。この不具合を再現するには、特定の順番で5つの操作が必要です。こうした複雑な操作を全てのリスト画面で手動検証するのは、時間的にも難しいのが現実です。
2つ目は投稿作成画面です。画像を2枚以上添付した状態でキャプションを入力すると、1文字打つたびに画像がちらつきました。画像ローダーが再描画のたびに強制的に読み込み直す設定になっていて、入力すると画面が再描画されるため、キー入力のたびに全ての画像を読み込み直していたのです。これは古い機能で起きたリグレッションでした。こうしたケースは普段のリグレッションテストでは実行していませんが、AIが見つけてくれました。
AIがこの2つのバグを見つけられた理由は、テストケースの設計方法にあります。設計を作るスキルは、仕様に書かれたケースのほかに、2種類のケースを足します。1つは、サーバーと通信する機能で、接続が切れる、回線が遅い・不安定、タイムアウト、サーバーエラーといった通信の異常を試すケースです。もう1つは、コードの差分から洗い出したリグレッションのケースです。機能テストのスキルはこの設計に沿ってテストするので、仕様に書かれていない操作まで試すことになり、それが今回の2つのバグにつながりました。
他の少人数QAチームに伝えたいこと
1つ目は、AIに仕事を任せる前に、アプリを深く知っておくことです。スキルの価値は、その成果物を私がどれだけ判断できるかで決まります。抜けているエッジケースに気づいたり、本当の失敗と記述のずれを見分けたりするには、アプリとそのドメインへの深い理解が要ります。AIはプロダクトをすでに知っている人を速くしてくれますが、その知識まで補ってくれるわけではありません。
2つ目は、失敗を全てルールとして書き残すことです。スキルが良くなったのは最初の版が優れていたからではなく、うまくいかなかった実行のたびに、何が起きたのかを1行ずつ書き足してきたからです。
3つ目は、AIに「分からない」と言える選択肢を与えることです。リグレッションスキルのNOT RUNと、機能テストスキルのNEEDS MANUALがあるからこそ、私のレポートの合格は、実際に通るのを確かめたという意味を持ちます。
4つ目は、仕様を正しい挙動の基準にすることです。コードはどこをテストすべきかを教えてくれます。Figmaは、画面の期待結果を具体的な数値で示してくれます。ただ、機能として何が正しいかを決めるのは、今のコードではなく、チームで合意した仕様です。
We’re Hiring
AnotherBallはエンタメとテクノロジーの交差点に立つ会社です。人々が愛するコンテンツやコミュニティとのつながりを深めるプロダクトを作りながら、その実現のためにAIをフルスタックで活用しています。
もしこういう環境に少しでも興味を持っていただけたら、ぜひ採用情報も見てみてください。